타자기가 아니라 화가
Inception Mercury와 체험 사이트 사용법
ChatGPT·Claude·Gemini는 글자를 하나씩 씁니다. Inception Labs의 Mercury는 문장 전체를 동시에 그립니다. 최초의 상용 디퓨전 LLM이 왜 중요한지, 그리고 수강생이 직접 체험할 수 있는 사이트의 네 가지 탭을 어떻게 돌려봐야 하는지.
AI가 글을 쓸 때 거의 모든 모델이 공유해 온 전제가 하나 있습니다. 왼쪽에서 오른쪽으로, 한 글자씩. ChatGPT도, Claude도, Gemini도 다음 글자를 예측해 하나 붙이고, 그 결과를 다시 입력으로 받아 그다음 글자를 예측합니다. 답이 길수록 느려지는 이유, 입력의 뒷부분을 참고하는 게 까다로운 이유, 서버 비용이 글자 수에 비례해 늘어나는 이유가 모두 이 전제에서 나옵니다. Inception Labs의 Mercury는 그 전제를 뒤집습니다. 문장 전체의 흐릿한 밑그림을 먼저 깔고, 여러 자리의 글자를 동시에 선명하게 복원합니다. 글자가 늘어나도 생성 속도가 거의 늘지 않습니다.
이 글은 두 가지를 다룹니다. 첫째, Inception과 Mercury가 왜 지금 중요한지. 둘째, 그 모델을 수강생이 설명 없이도 "느끼게" 하려고 만든 체험 사이트 inception-mercury-studio.vercel.app을 네 가지 탭 순서대로 어떻게 돌려봐야 하는지. 모델 자체가 궁금하신 분은 끝까지, 수업에서 어떻게 쓸지가 궁금하신 분은 중간 네 섹션(05~08)만 보셔도 됩니다.
01 / Inception Labs스탠퍼드에서 나온 디퓨전 LLM 전문 회사
Inception Labs는 미국 스탠퍼드대 교수이자 디퓨전 모델 연구의 핵심 인물 중 한 명인 Stefano Ermon이 CEO로 세운 회사입니다. 팀은 Stanford, UCLA, Cornell, Google DeepMind, Meta AI, Microsoft AI, OpenAI 출신 연구자·엔지니어로 구성되어 있고, 2025년 초 Mercury Coder를 공개하며 세계 최초의 상용 디퓨전 기반 LLM이라는 수식어를 붙였습니다. 그 뒤로 Mercury 2(2026년 6월), Mercury 3(현재 플래그십)로 세대를 올렸고, 음성 에이전트용 Mercury Voice와 구조화된 의사결정용 Mercury Decide 같은 특화 모델까지 계열을 넓혔습니다. 이미 Fortune 500 기업에 도입 중이라고 밝히고 있습니다.
중요한 점은 이름이 아니라 접근 방식입니다. 그동안 거의 모든 상용 LLM은 자기회귀(auto-regressive) 구조였습니다. OpenAI, Anthropic, Google, Meta의 공개 모델이 모두 그렇습니다. Inception은 이미지·영상 생성에서 지배적이 된 디퓨전(diffusion) 구조를 처음으로 글자 생성에 상용 규모로 가져왔습니다. 지난 10년간 AI가 글을 쓰는 방식 자체가 바뀌는 첫 시도입니다.
02 / 타자기와 화가자기회귀 vs 디퓨전의 차이
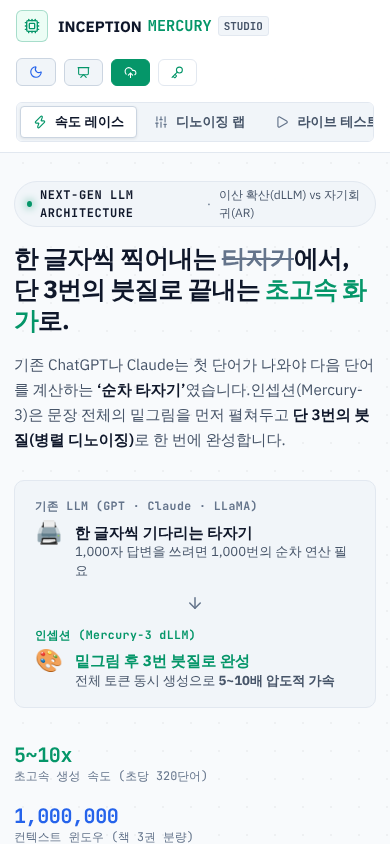
차이를 그림 하나로 바꾸면 이렇게 됩니다. 기존 AI는 타자기입니다. 한 글자 찍고, 그 결과를 보고 생각하고, 또 한 글자. 답이 길어질수록 시간이 글자 수에 비례해 늘어납니다. Mercury는 화가입니다. 캔버스 위에 문장 전체의 흐릿한 밑그림을 한 번에 깔고, 모든 자리의 글자를 동시에 조금씩 선명하게 만듭니다. 보통 3~10번의 "붓질"로 완성됩니다. 10글자든 1,000글자든 붓질 횟수는 거의 같기 때문에, 긴 답일수록 속도 격차가 벌어집니다.
이 차이는 기술 애호가의 호기심이 아니라 실제 서비스 설계를 바꿉니다. 자기회귀 모델에서는 "응답이 길어지면 느려진다"가 전제이고, 그래서 짧게 끊어 흘리는 스트리밍 UI가 표준이 되었습니다. 디퓨전 모델에서는 "응답이 길어도 거의 같은 시간"이 전제이고, 그래서 한 번에 완성된 긴 답을 전제로 하는 에이전트·코드 생성·실시간 음성 응답 같은 쪽에 유리합니다.
03 / Mercury 3 숫자$0.10, 1,000 tok/s, OpenAI 호환
현재 플래그십인 Mercury 3는 공식 페이지 기준으로 입력 1M 토큰당 $0.10, 출력 1M 토큰당 $0.35로 책정되어 있습니다. 참고로 GPT-5나 Claude 계열 상위 모델의 1M 토큰당 가격이 같은 등급에서 수 달러 단위라는 걸 생각하면, 한 자릿수 센트 가격은 체감 자체가 다릅니다. 성능 지표로는 첫 토큰 응답 시간(TTFT) 300ms 미만, 기존 대비 처리량 5~7배, 작업당 비용 최대 70% 절감을 내세웁니다. 초기 Mercury Coder 때는 NVIDIA H100 기준 초당 1,000 토큰이 넘는 생성 속도가 보고됐습니다. Mercury 2는 2026년 6월 발표 시 AIME 2026 수학 벤치마크에서 90%를 기록해 Google의 오픈웨이트 DiffusionGemma(69.1%)를 앞섰다는 수치가 보도된 바 있습니다.
쓰기 쉽다는 점도 중요합니다. API는 OpenAI API 호환이어서 기존 코드에서 엔드포인트와 모델명만 바꿔도 거의 그대로 돌아갑니다. AWS Bedrock, Azure Foundry 같은 주요 클라우드에서도 쓸 수 있어 폐쇄망·VPC 환경에 올리기도 수월합니다. 수치는 대부분 회사 자체 보고이니, 각자 업무에 맞춰 직접 돌려 보는 게 가장 정확합니다. 그래서 체험 사이트가 필요했습니다.
04 / 체험 사이트왜 '설명'이 아니라 '체험'인가
강의 현장에서 가장 많이 받는 질문이 "확산 방식 언어 모델이 뭐가 다른데요?"입니다. 자기회귀, 병렬 디노이징, 양방향 어텐션 같은 단어로 설명을 시작하는 순간 수강생의 눈이 감깁니다. 그래서 설명 대신 직접 눌러보게 하는 쪽을 택했습니다. inception-mercury-studio.vercel.app이 그 결과물입니다. 코드는 github.com/cdsassj00/inception에 공개되어 있고, 로그인·결제 없이 바로 열립니다(단, 라이브 테스트는 Inception API 키가 필요합니다 — 사이트 안내에 넣어 두었습니다).
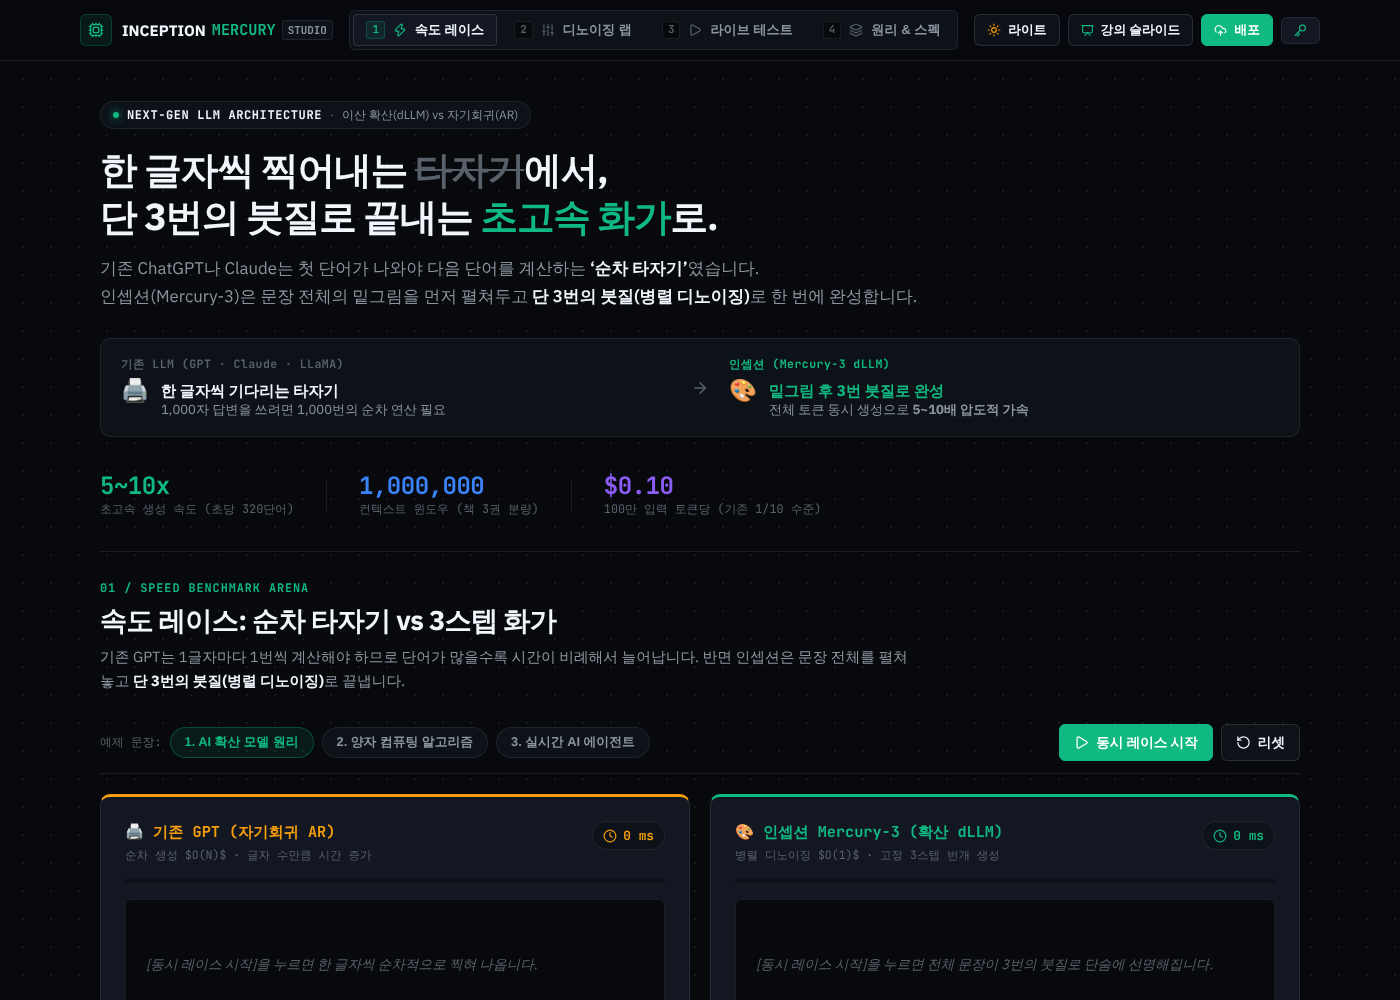
상단에는 네 개의 탭이 있습니다. 라이브 테스트, 속도 레이스, 디노이징 랩, 원리 & 스펙입니다. 순서대로 돌려보시는 걸 권합니다. 처음 세 탭은 "느끼는" 자리이고, 마지막 탭은 "확인하는" 자리입니다. 각 탭이 무엇을 보여주는지 아래 네 섹션에서 짧게 짚어 두겠습니다.
05 / 라이브 테스트진짜 Mercury에게 묻고 비교하기
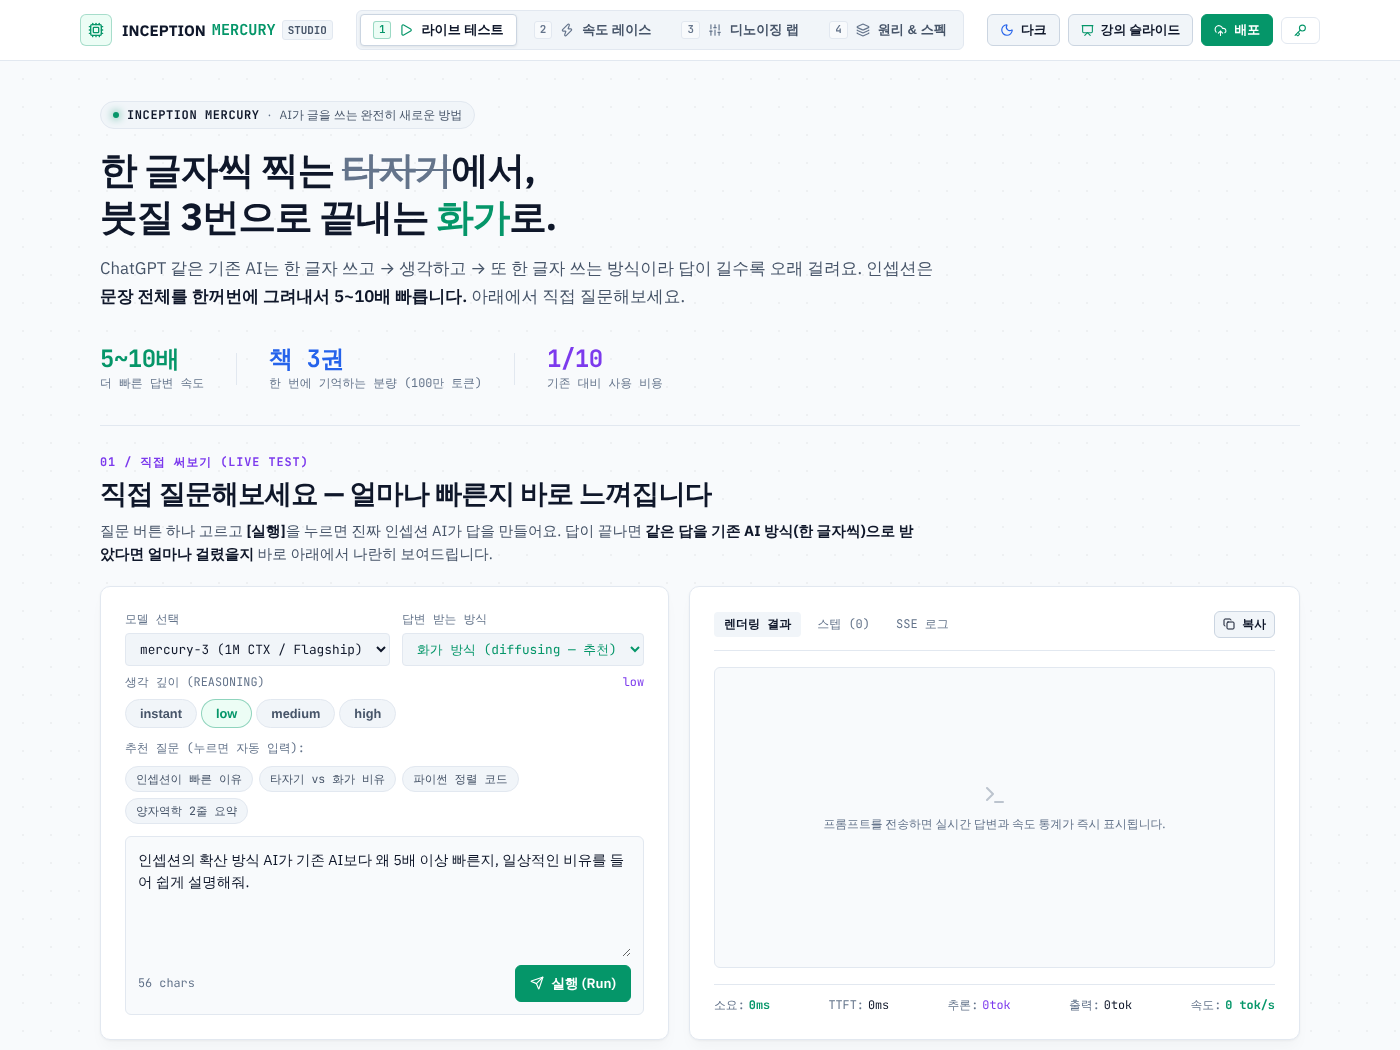
첫 번째 탭입니다. 모델 선택란은 mercury-3 (1M CTX / Flagship)으로 기본 세팅되어 있고, "답변 받는 방식"에서 화가 방식(diffusing)이 추천값입니다. 그 아래 생각 깊이(REASONING)는 instant / low / medium / high 네 단계입니다. instant는 즉답, high로 올릴수록 더 숙고하지만 답이 늦게 돌아옵니다. 처음에는 low로 두시면 체감이 가장 선명합니다.
추천 질문 네 개가 미리 준비돼 있습니다. "인셉션이 빠른 이유", "타자기 vs 화가 비유", "파이썬 정렬 코드", "양자역학 2줄 요약". 하나 눌러 실행하면 진짜 Inception API가 답을 만들어 돌려줍니다. 답이 끝나는 순간 흥미로운 일이 일어납니다.
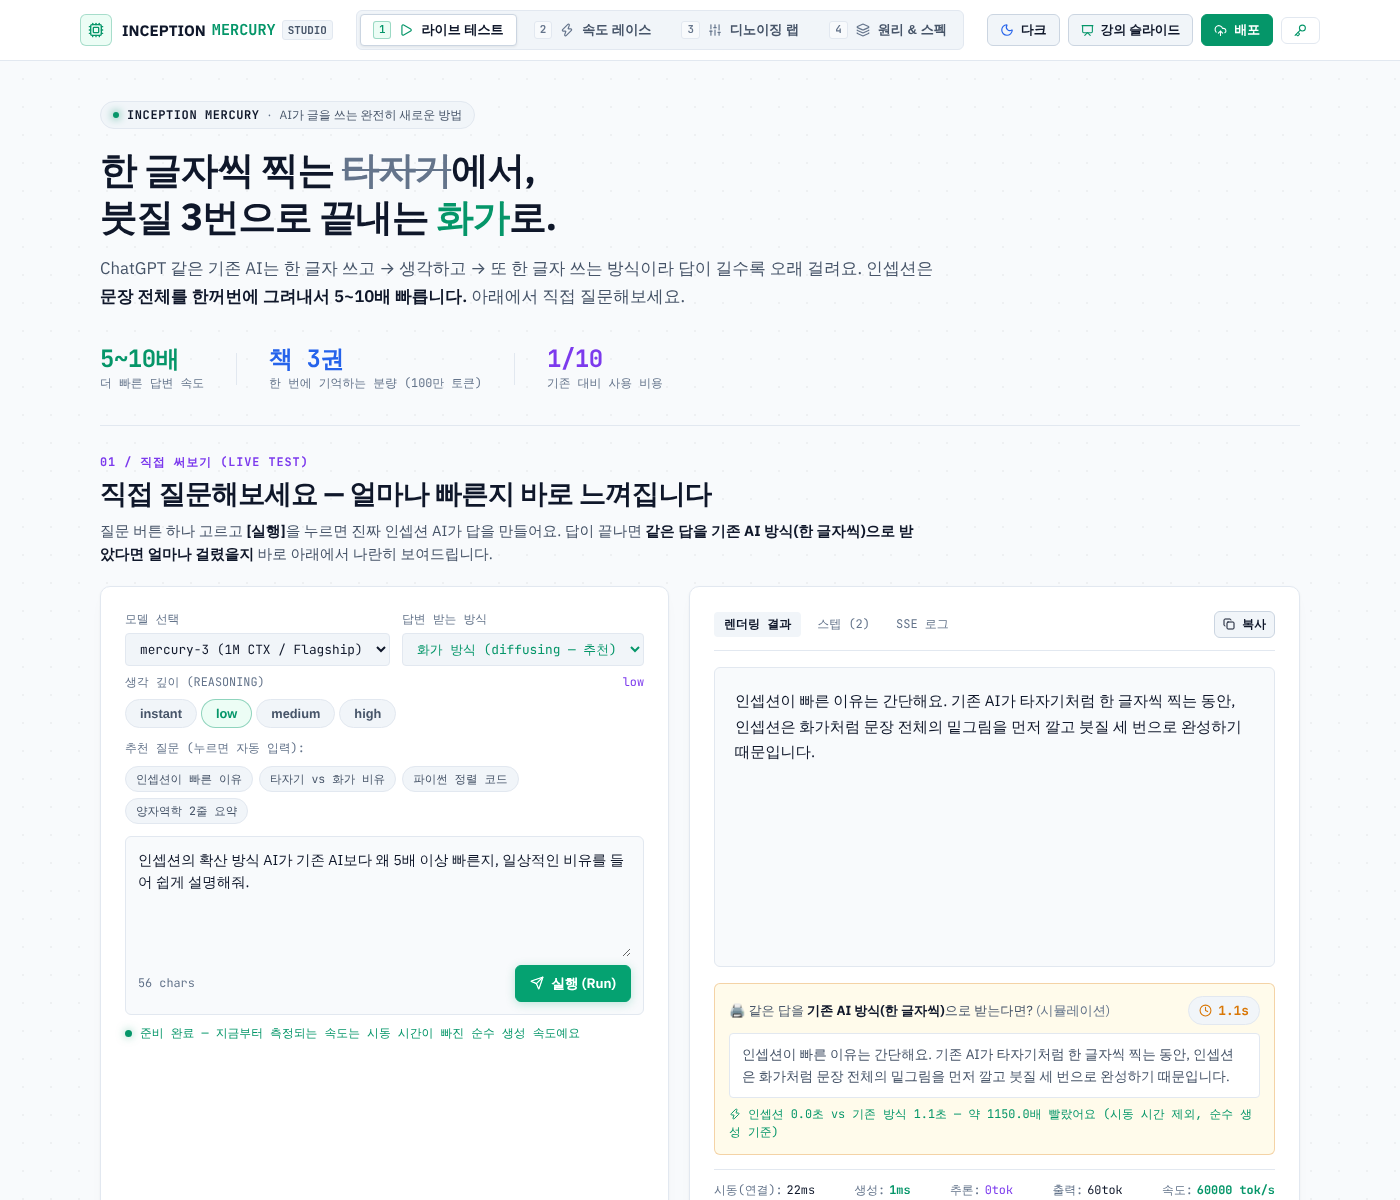
아래 패널에서 동일한 답을 자기회귀 모델의 평균 속도(초당 약 80자)로 다시 한 글자씩 타이핑하기 시작합니다. Mercury는 이미 끝났는데 아래는 아직 치고 있는 모습이 핵심입니다. 끝나면 "Mercury 1.2초 vs 기존 방식 11.3초 — 약 9배" 식으로 정리됩니다. 기다리기 지루하면 "건너뛰기"를 눌러도 됩니다.
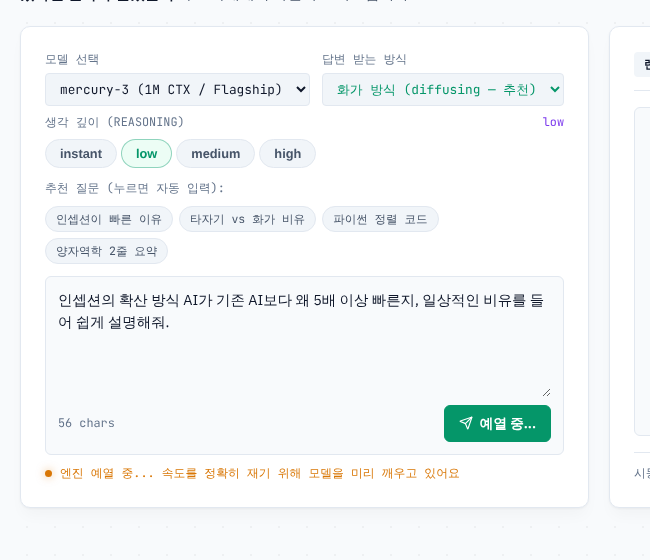
속도 수치를 정직하게 보기 위해 두 가지 장치를 더 넣었습니다. 하나는 자동 예열입니다. 처음 들어오면 1토큰짜리 초소형 요청을 미리 보내 모델을 깨우고, 그 사이 실행 버튼은 "예열 중…"으로 잠깁니다. 콜드 스타트 시간을 "생성 속도"에 섞어 넣지 않기 위해서입니다. 다른 하나는 시동과 생성의 분리 측정입니다. 첫 바이트가 돌아올 때까지를 "시동(TTFT)", 그 이후를 "생성"으로 나눠 보여주고, tok/s와 배수 비교는 순수 생성 시간만 씁니다.
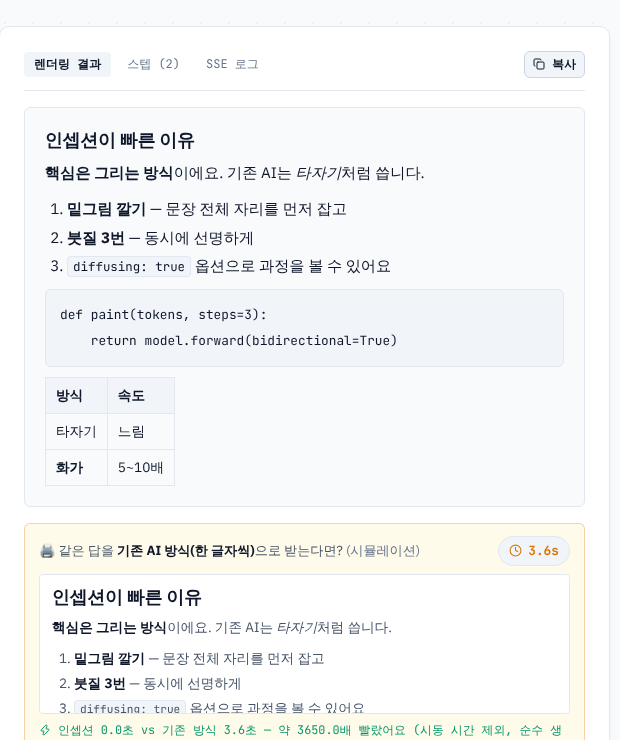
답변은 마크다운으로 깔끔하게 그려집니다. 굵은 글씨·리스트·코드블록·표가 섞여도 그대로 포맷을 지킵니다. 아래 "기존 AI" 비교 패널은 타이핑 중에는 날것 그대로(타자기 느낌), 끝나면 마크다운으로 정리되는 작은 디테일이 있습니다.
06 / 속도 레이스글자 수가 늘어도 왜 안 느려지는가
두 번째 탭입니다. 같은 질문을 "자기회귀 vs 디퓨전"에서 각자 돌리고, 응답 길이를 늘렸을 때 두 모델의 시간이 어떻게 달라지는지를 그래프로 보여줍니다. 자기회귀 쪽은 글자 수에 거의 선형으로 늘어나는 반면, 디퓨전 쪽은 거의 평평한 선을 그립니다. "길어질수록 격차가 벌어진다"가 머리로가 아니라 눈으로 들어옵니다. 이 탭은 특히 임원 대상 설명에서 효과가 큽니다. 한 장의 선 그래프가 열 장짜리 설명 슬라이드를 대체합니다.
07 / 디노이징 랩흐릿한 글자가 선명해지는 3번의 붓질
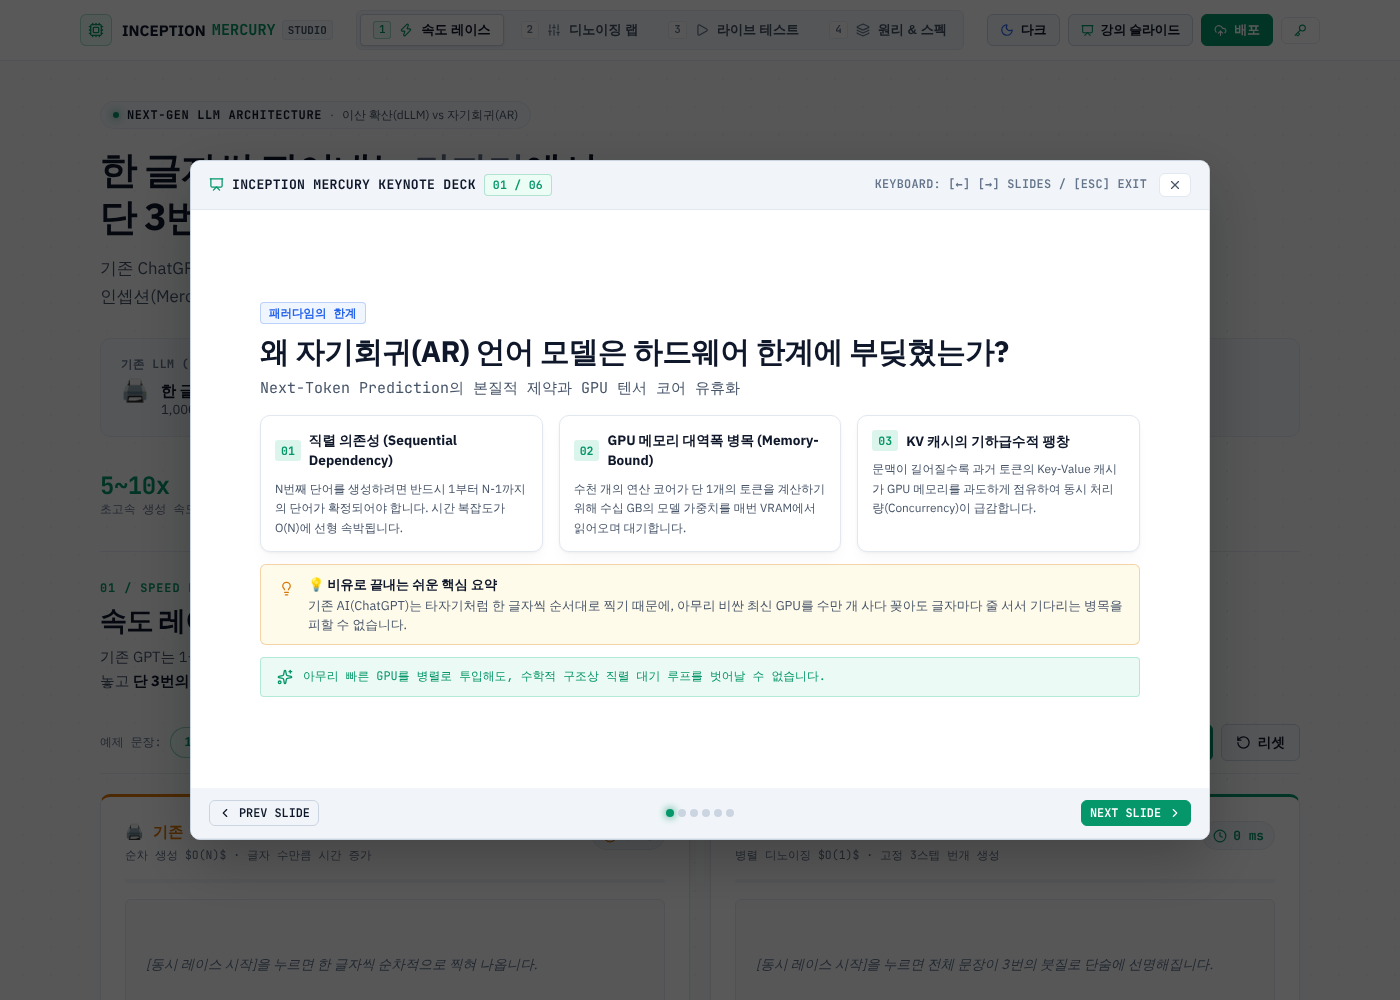
세 번째 탭이 체험의 핵심입니다. Mercury가 글자를 복원하는 과정을 슬라이더로 되감아 보는 자리입니다. 0단계에서는 자리마다 흐릿한 추정만 있고(마스크 상태), 1단계에서 윤곽이 잡히고, 2단계에서 문장이 거의 완성되고, 3단계에서 선명해집니다. 사람이 그림을 그릴 때 전체 윤곽을 먼저 잡고 세부를 올리는 과정과 같습니다. "왼쪽에서 오른쪽으로 한 글자씩" 쓰는 자기회귀 모델에서는 이 중간 단계라는 개념 자체가 존재하지 않습니다. 글자를 확률 공간에서 "뽑아내는" 것이 아니라 "복원하는" 모델이라는 감각이 여기서 처음 생깁니다.
08 / 원리 & 스펙개발자·연구자용 심화
네 번째 탭은 지금까지의 체험을 수학과 아키텍처로 정리하는 자리입니다. 자기회귀의 O(N) 지연과 디퓨전의 O(1) 고정 스텝, 양방향 어텐션의 역할, 메모리 바운드 병목, 왜 디퓨전 모델이 GPU 활용도가 더 높은지 같은 이야기가 들어 있습니다. 이 탭은 심화 섹션이라고 명시해 두었습니다. 수강생 중 "왜?"를 끝까지 파고드는 분을 위한 자리이고, 나머지는 앞 세 탭만 돌려 봐도 체감은 충분합니다.
09 / 교실에서어떻게 쓰면 좋은가
CDSA 현장에서는 세 가지로 쓰고 있습니다. 첫째, LLM 개론 입문의 첫 15분. "AI가 글을 쓴다"라는 익숙한 그림을 흔들어 주는 자리로 라이브 테스트와 디노이징 랩을 돌립니다. 둘째, 임원 브리핑. 속도 레이스 그래프 한 장으로 "에이전트 시대의 응답 지연이 왜 문제인지"를 10초에 전달할 수 있습니다. 셋째, 바이브 코딩 실습의 후반부. OpenAI 호환 API라는 점을 이용해, 수강생이 짠 작은 챗봇의 모델 엔드포인트만 바꿔 "같은 코드로 Mercury 돌려보기"를 숙제로 냅니다. 가격이 한 자릿수 센트라 교육 예산에도 큰 부담이 없습니다.
모델 패러다임이 바뀌는 걸 설명으로 전하는 데에는 한계가 있습니다. 한 번 눌러본 사람과 열 번 설명을 들은 사람 중, 더 오래 기억하는 쪽은 늘 전자였습니다.
Inception Mercury는 "GPT를 대체한다"는 류의 모델이 아닙니다. 지난 10년간 당연했던 "글자는 왼쪽에서 오른쪽으로 하나씩" 전제를 흔드는 모델이고, 그래서 가장 큰 의미는 성능 숫자보다 다른 선택지가 있다는 사실 자체에 있습니다. 속도와 비용이 중요한 특정 영역에서는 이미 기본값이 될 가능성이 큽니다. 그 변화를 체감한 수강생이 나중에 자기 현장의 "느려서 못 쓰던 자리"에 Mercury 같은 모델을 떠올려 준다면, 이 체험 사이트의 역할은 다한 것입니다. 사이트와 코드는 아래 링크에 열어 두었으니, 수업·사내 세션·개인 호기심 어디에 쓰셔도 좋습니다.